在药物设计中,找到一个能够结合靶点的分子,往往只是起点。真正困难的是后续优化:研究人员既希望提高溶解性、类药性和合成可及性,又不愿破坏已经获得的生物活性。多个目标彼此牵制,一处看似局部的结构改动,可能同时改变分子的脂溶性、构象、代谢稳定性乃至靶点结合。如何在尽量保留原有功能的前提下,做出“小而有效”的化学修改,是先导化合物优化中的核心问题。
生物电子等排替换正是解决这一问题的经典策略。它以一个化学片段替换另一个在结构、电子或生物学功能上相近的片段,希望微调分子性质,同时维持关键相互作用。过去,这项工作高度依赖药物化学家的经验;数据库方法虽然可以从匹配分子对中总结常见替换规律,却通常仍需要人工指定修改位置,而且难以处理数据库中少见的片段,更难同时控制依赖全分子结构的复杂性质。
2026年7月,韩国科学技术院与HITS Inc.团队在《Nature Communications》发表文章,题为“Autonomous bioisosteric replacement for multi-property optimization in drug design”。作者提出一种名为DeepBioisostere的方法,把生物电子等排替换建模为一个端到端的序列决策过程:模型不仅推荐换成什么,还自主决定从哪里换以及怎样接回去,并根据给定条件同时调节多个分子性质。作者希望把原本依赖经验和预设规则的局部改造,推进为可计算、可条件控制的分子优化流程。
DeepBioisostere代码仓库:https://github.com/Hwoo-Kim/DeepBioisostere
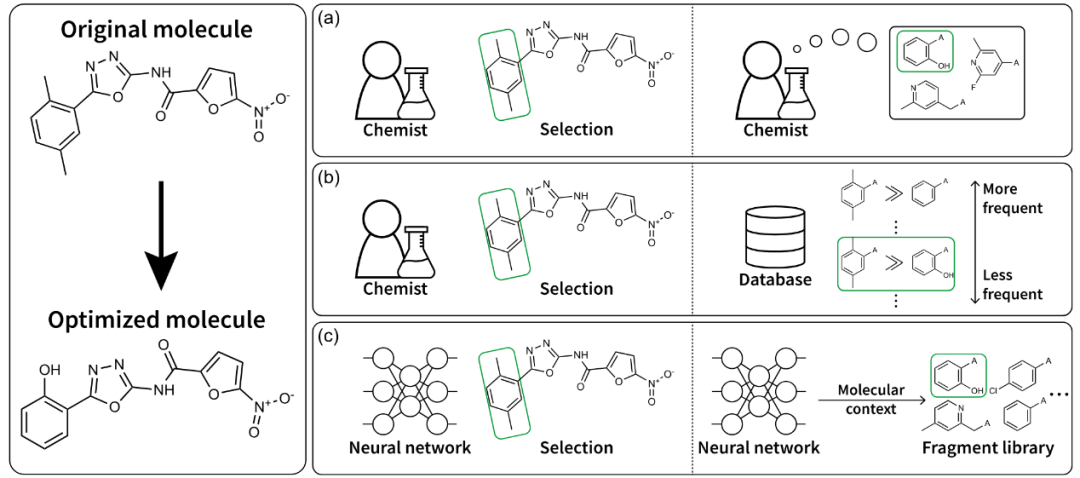
图1|三种生物电子等排替换方式,人工方法由药物化学家选择替换位点和候选片段;数据库方法仍需人工确定删除片段,再按历史频次推荐替换;DeepBioisostere则结合完整分子环境,自主选择删除片段、插入片段及连接方式。
从推荐片段走向端到端替换
DeepBioisostere将一次结构修改拆成三个连续步骤:选择需要删除的片段,从片段库中选择插入片段,再预测新片段与剩余结构的连接方向。模型首先按BRICS规则把分子切分成化学上较合理的片段,并将原分子同时表示为原子图和片段图。原子级消息传递网络捕捉局部化学环境,片段级网络进一步整合片段与周围结构之间的关系。性质控制条件也被加入表示,使同一个分子在提高脂溶性和降低脂溶性等不同目标下,可以触发不同的修改决策。
训练数据来自ChEMBL。团队从约418万条分子记录出发,经过分子量、盐形式和活性等预筛选,保留约105万种分子,再用BRICS切分和匹配分子对方法寻找仅有小范围结构差异、且在同一生物测定中保持活性的分子对。最终训练数据包含约287万组匹配分子对,形成包含140,096个片段的候选库。与单纯统计片段出现频率不同,模型学习的是原分子、性质目标与替换结果之间的条件关系。
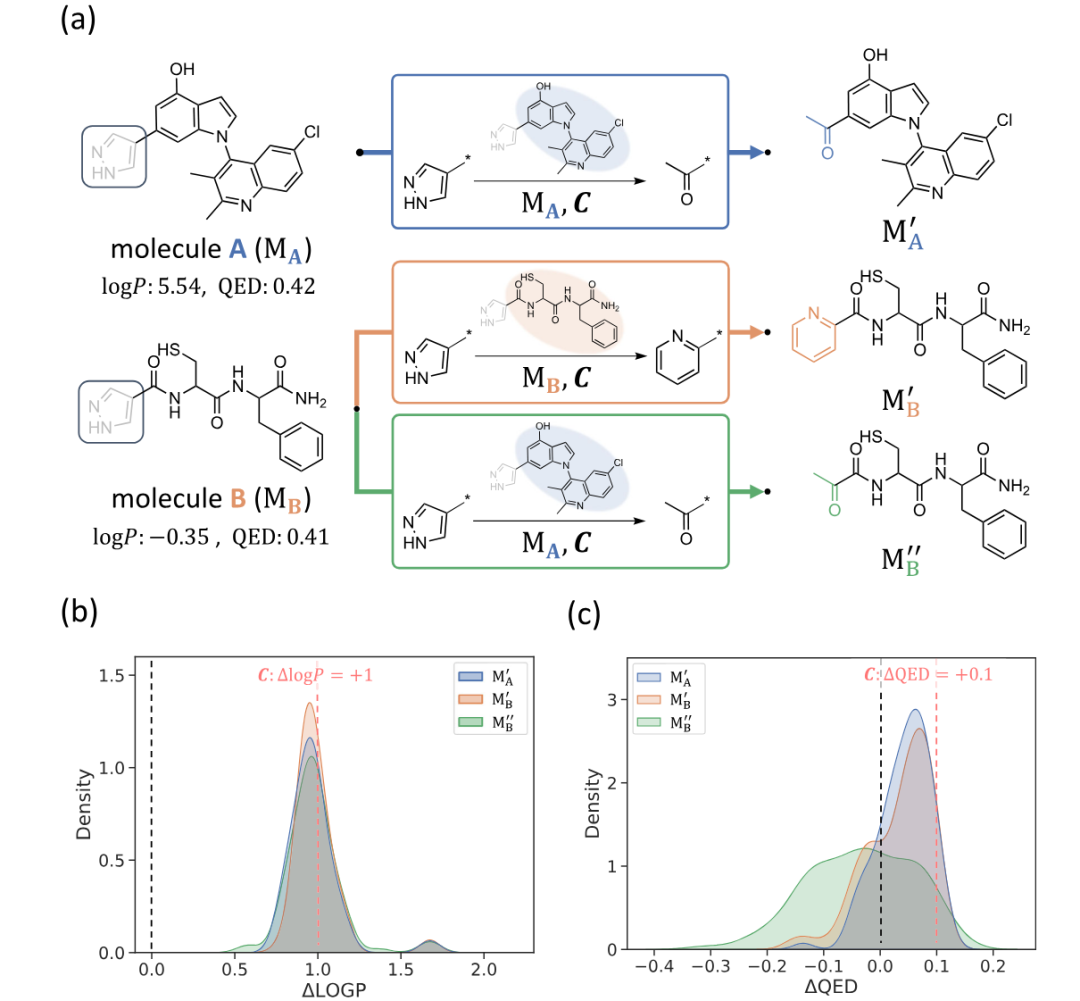
这一设计的关键,是替换片段不能脱离其所在的化学环境。一个片段在分子A中能够改善性质,并不意味着放入分子B后仍然有效。论文用两个都含吡唑基、但周围取代基和整体脂溶性差异很大的分子进行验证。把针对分子A选出的片段直接移植到分子B时,logP仍可能按预期变化,但QED反而下降。这是因为logP在一定程度上可以看作局部基团贡献的累积,而QED是由分子量、氢键供受体、芳香性、柔性等多种全局特征共同决定的非线性指标。实验说明,对复杂性质的优化不能只记住某片段通常带来什么变化,还要判断它进入当前分子后会产生什么结果。
同时改变一个性质,并保留另一个性质
作者设置了三组双性质控制任务。第一组要求在分子量基本不变时,将logP提高或降低1。logP相差1对应辛醇—水分配比约10倍的变化,因此这不是简单的数值微调。模型生成的分子平均logP分别变化+0.83和-0.84,而分子量平均仅变化+0.04和-0.28,表明它能够在几乎不改变分子尺度的情况下调节脂溶性。
第二组任务是在保持分子量的同时提升QED。面对初始QED低于0.4的分子,模型收到“提高0.1”或“提高0.2”的条件后,实际平均提升分别为0.067和0.100。目标越激进,结果与要求之间的偏差越大,原因之一是训练集中能够带来大幅QED改善的替换本就稀少。这一结果也提示,条件生成模型并不保证精确达到输入目标,它更像是在已有化学空间中寻找最接近要求的可行改动。
第三组任务要求降低合成可及性评分SAscore,同时尽量维持较高QED。需要注意,SAscore越低,通常表示预计越容易合成。当目标是将SAscore降低0.5或1.0时,实际平均变化为-0.424和-0.719,而QED平均仅下降0.026和0.028。模型没有完全达到设定幅度,但在两个相互牵制的代理指标之间取得了较好的平衡。
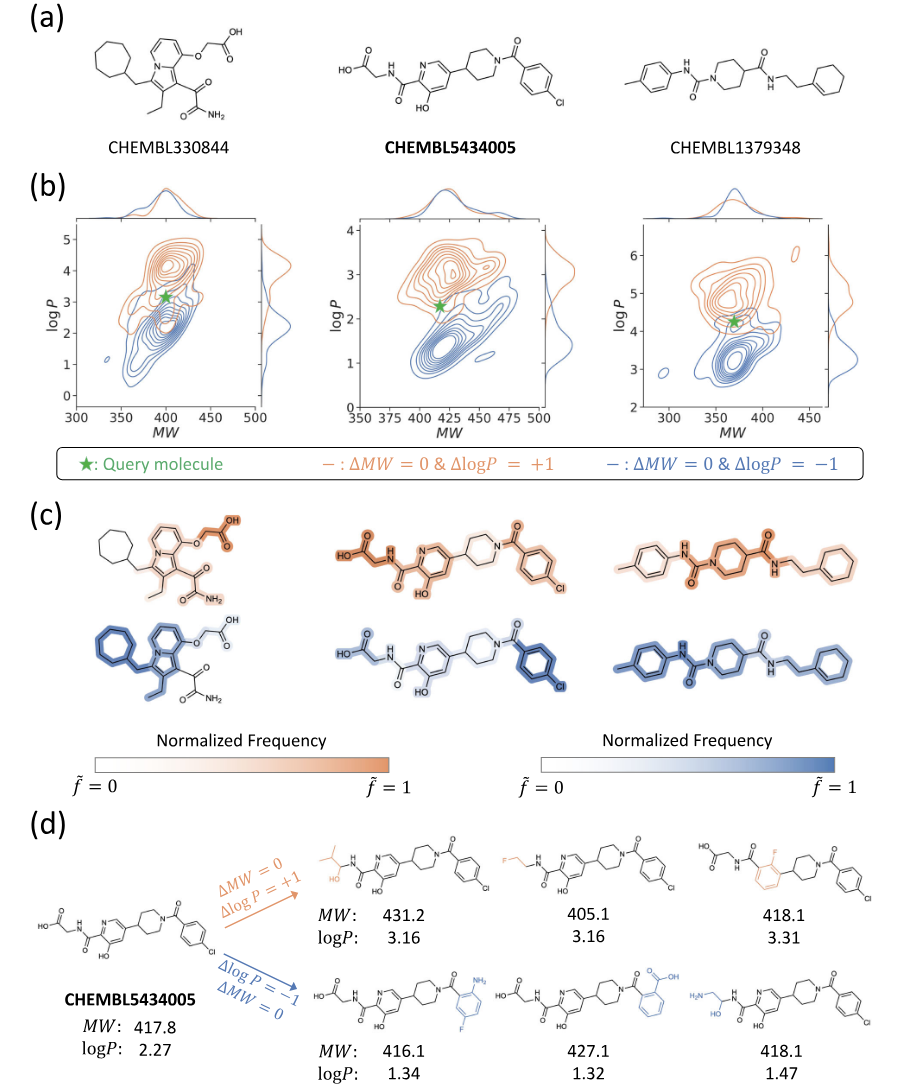
图2|性质条件会改变模型选择的替换位置,橙色表示提高logP、蓝色表示降低logP,模型针对同一分子选择不同删除片段,并生成分子量相近而脂溶性方向相反的结构。
这些结果背后的重要变化,是模型开始共同决定改哪里和怎么改。以论文中的CHEMBL5434005为例,当目标是提高logP时,模型倾向替换亲水性的羧酸基;当目标变为降低logP时,更常选择氯苯片段。也就是说,模型不是先由人固定一个修改位置,再在有限列表中挑替代物,而是让替换位点本身随优化目标变化。这更接近药物化学家在实际项目中的思考方式。
在数据库没有现成答案时扩展候选空间
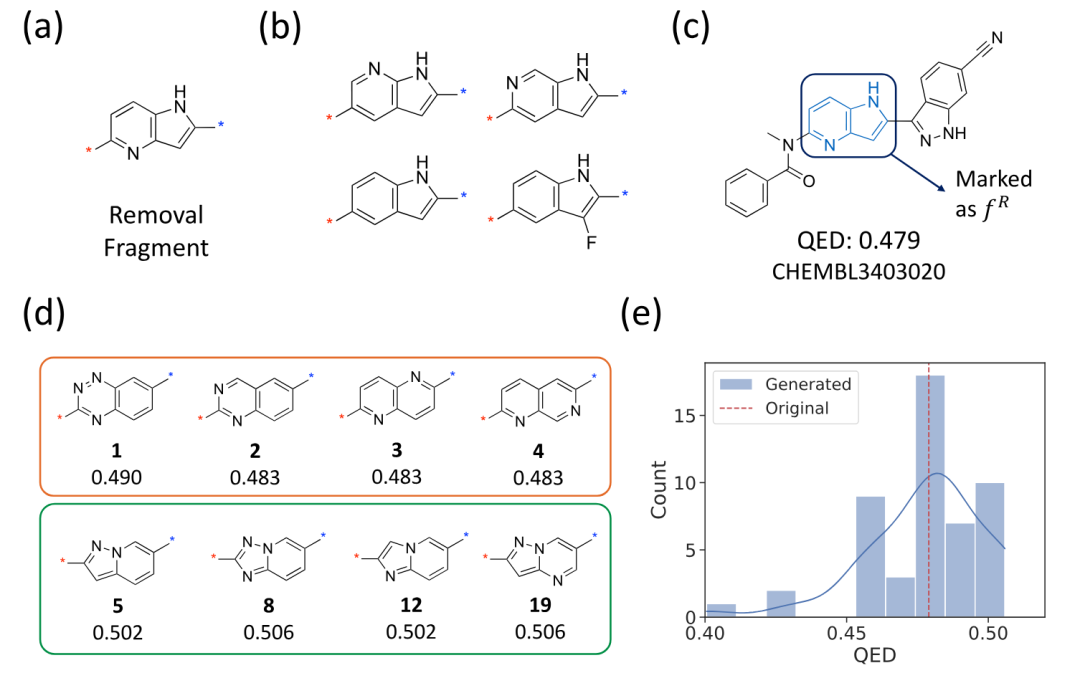
数据库挖掘方法的局限在罕见片段上尤为明显。团队建立的140,096个片段中,有98,459个片段在数据库里对应的已知生物电子等排体不超过10个。以4-氮杂吲哚片段为例,匹配分子对数据库只能找到4种替代片段,而且大多只是重原子略有差别的稠合杂环,能够探索的结构空间非常有限。
研究人员固定4-氮杂吲哚为删除片段,并要求替换前后QED保持不变。DeepBioisostere从完整片段库中生成50个新结构,排名靠前的候选不仅包括六元环与五元环稠合体系,还出现了两个六元环组成的体系。它们与原片段结构并不完全相似,却保留了相近的氢键位点、芳香环数量和脂溶性,生成分子的QED也集中在原分子附近。这说明模型有机会提出数据库中没有直接记录、但在当前分子环境下可能发挥类似功能的替换方案。
图3|罕见片段的替换探索。数据库仅给出少量相近稠合杂环;DeepBioisostere进一步提出结构更为多样的候选,并使替换后分子的QED接近原分子。
先导优化
论文最后将DeepBioisostere接到Pocket2Mol、DeepICL、TargetDiff和DecompDiff四种结构基础3D分子生成模型之后。作者从CrossDocked2020测试集中选择3个靶点,专门挑出QED偏低、SAscore偏高的计算生成分子,再要求DeepBioisostere提高QED、降低SAscore并尽量保持对接分数。
在PDB靶点4RV4上,DeepBioisostere处理四类模型生成分子后,同时满足QED改善、SAscore改善和对接分数保持的联合成功率分别为0.56、0.56、0.72和0.68。相比之下,随机、频次和匹配分子对分析三类替换策略的联合成功率多为0.06—0.36。单独看对接分数,各种策略普遍都能保持较高成功率;真正拉开差距的是能否在保留对接结果的同时改善另外两个性质。
图4|虚拟hit-to-lead案例,两个DeepICL生成分子经片段替换后,QED提高、SAscore降低,同时计算对接分数基本保持。粉色为原片段,紫色为替换片段。
这组实验展示了一个值得关注的组合思路:3D生成模型负责提出与蛋白口袋匹配的初始结构,DeepBioisostere再处理类药性和合成复杂度等问题。它不是取代前端生成模型,而是充当下游的“结构修整器”,使分子向先导化合物要求靠近。
但论文所称的hit-to-lead仍是虚拟流程。QED和SAscore是启发式指标,对接分数也不能等同于真实结合亲和力;所谓“保持活性”,在该部分实际上是保持计算对接结果,而不是经过生化实验验证。数据构建虽然使用同一测定中的活性分子对来学习替换规律,却仍难覆盖不同靶点、构象、立体化学和ADMET终点。作者也提出,未来需要通过多任务学习和迁移学习,将易获得的QED、logP和SAscore知识转移到标签更稀缺、噪声更高的ADMET性质上。
总结
DeepBioisostere的价值,不在于把分子生成规模继续做大,而在于把药物设计中的一种经典操作转化为可条件控制的完整决策。它将修改位点、替换片段和连接方式纳入同一流程,并显式考虑完整分子环境,使模型能够在多个目标之间寻找折中,也能为罕见片段提出数据库之外的候选。这项工作同时揭示了当前AI分子优化的边界:模型已经能够在计算指标上进行有方向的精细修改,但距离“自主完成先导优化”仍缺少合成、活性、选择性和ADMET实验闭环。更现实的定位,是把DeepBioisostere视为药物化学家的候选方案生成与优先级排序工具。它可以扩大可考虑的替换空间、减少对固定规则的依赖,并帮助研究人员更快提出值得验证的结构;最终哪些替换真正有效,仍要由实验和项目语境作出判断。
参考链接:https://doi.org/10.1038/s41467-026-75512-9
本文转载于智药邦:https://mp.weixin.qq.com/s/V6J_F913vKN7WplrcNyLyQ |